写真と質問を組み合わせると、
AIに何が伝わる?
文字だけでなく、画像や音声も使って相談できるのがマルチモーダルAIです。写真を説明し直さなくても、画像と「何を知りたいか」を一緒に渡せます。
本記事では、本棚の写真をChatGPTに見せた実回答を掲載します。5冊の主な書名は一致しましたが、文字の色の説明には写真と違う部分がありました。この実例から、できることと回答を確認する方法を整理します。
文字・画像・音声・動画など、複数の種類の情報を扱うAIのことです。たとえば、写真と「何が写っている?」という質問を組み合わせて、文章で説明してもらえます。
便利に使うコツは、見る場所・してほしい作業・答え方を一緒に伝えること。写真にない情報や、読めない文字まで正しく分かるとは限りません。
マルチモーダルは「複数の情報の種類を扱う」という意味
「モダリティ」は、ここでは情報の種類や表現の形式を意味します。文字、写真、音声などが例です。「マルチ」は複数という意味なので、難しく考えず、複数の種類を組み合わせて扱えるAIと捉えると分かりやすくなります。
本の背表紙、文字、色、左右の配置などの見た目。
「読める書名と位置を説明し、不明な文字は補わないでほしい」。
| 用語 | 注目していること | 身近な例 |
|---|---|---|
| マルチモーダルAI | 複数の情報の種類を扱えるか。 | 画像と文章を一緒に渡して、内容について質問する。 |
| 生成AI | 文章や画像など、新しい出力を作るか。 | 文章を下書きする、イラストを作る。 |
一つのAIが、両方の性質を持つこともあります。写真と文章を受け取り、その内容を説明する文章を作るAIなら、複数の情報を扱うことと、文章を生成することが同じやり取りの中で行われます。
あわせて読みたいAIはどうやって画像を作るの?画像生成AIの仕組みを初心者向けに解説画像を読み取る機能と、画像を作る機能の違いを、仕組みと修正例から説明しています。本棚の写真で、書名と位置を読み取ってもらった
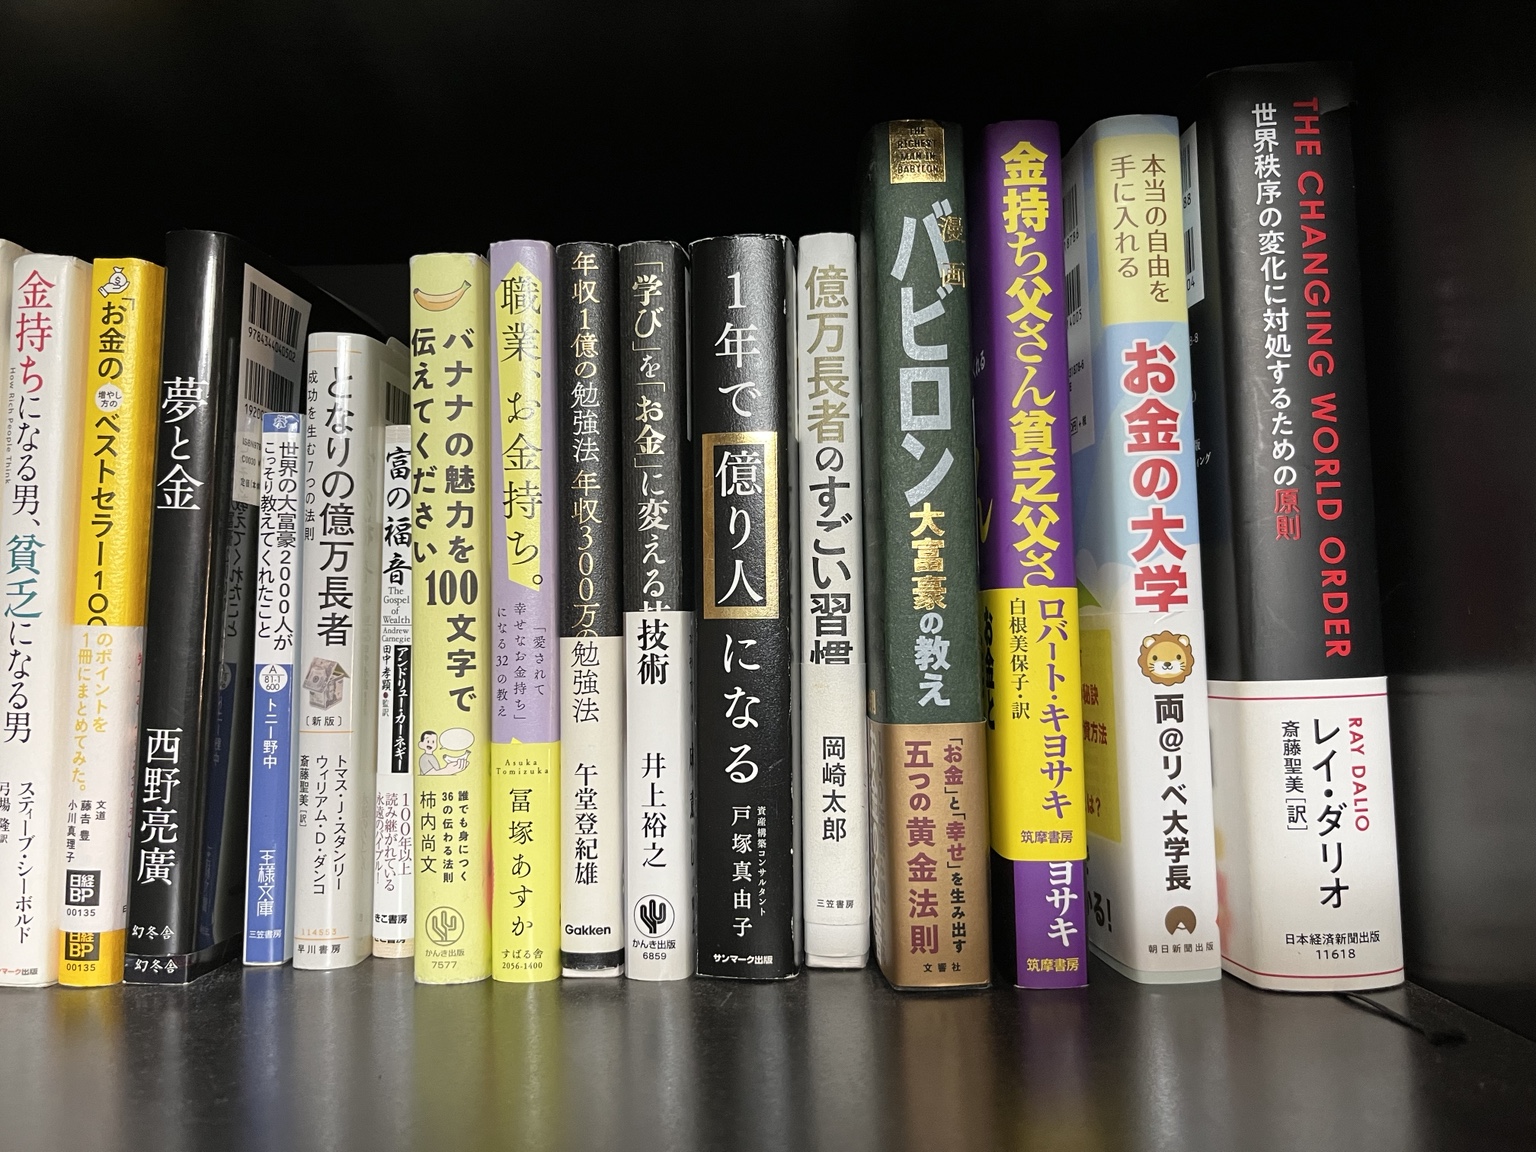
言葉の説明だけでなく、本棚の写真をChatGPTへ渡した実回答を、元の写真と見比べました。書名だけでなく、写真のどこにあるか、見た目の説明が合っているかも確認しています。
挙げた5冊の主な書名は一致
回答に挙がった5冊の書名を、写真の背表紙の表記と照合できました。
文字の色に、合わない部分があった
『1年で億り人になる』の「億り人になる」は白い文字ですが、回答は黒い文字と説明しました。
検証に使った写真と、AIの実回答
ここを比べると、違いが分かる
①写真:金色の枠内の「億り人」と、その下の「になる」は、どちらも白い文字です。
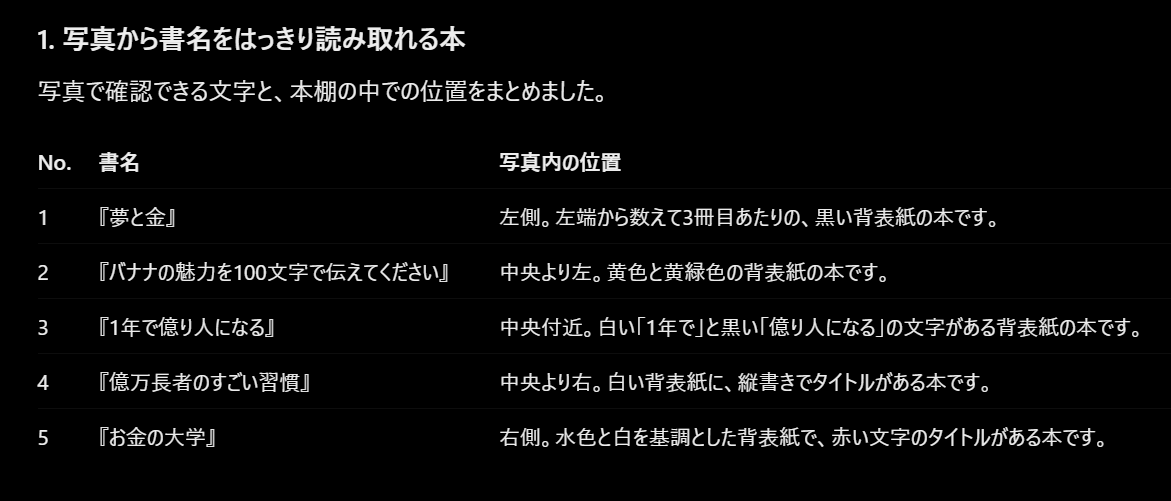
②AIの説明:「億り人になる」をまとめて黒い文字と説明しています。
照合した結果:書名は合っています。ただし、文字色の説明は一部違いました。写真と回答の同じ箇所を見比べると、この違いを確かめられます。
どんな条件で質問したか
検索を使わないことは質問に含めた条件です。掲載画面だけで、内部の処理や通信まで確認したわけではありません。
この本棚の写真について、次のことを教えてください。

1. 書名をはっきり読み取れる本を、最大5冊挙げてください。
2. それぞれが写真の左・中央・右のどこにあるか説明してください。
3. 読めない文字や隠れている部分は「確認できない」と書いてください。

写真から確認できる事実と、推測になることを分けてください。
インターネット検索は使わず、読めない文字を推測で補わないでください。
実回答と、元の写真を照合する
ChatGPTは、書名と位置を次の表で回答しました。書名・AIの説明は実回答の書き起こし、右の列は本記事で写真と照合した結果です。
| AIが挙げた書名 | AIの位置・見た目の説明(原文) | 写真との照合 |
|---|---|---|
| 01 『夢と金』 | 左側。左端から数えて3冊目あたりの、黒い背表紙の本です。 | 書名は一致。左側にあり、黒い背表紙という説明も写真と整合します。 |
| 02 『バナナの魅力を100文字で伝えてください』 | 中央より左。黄色と黄緑色の背表紙の本です。 | 書名は一致。中央より左という位置と、黄色・黄緑色という説明も写真と整合します。 |
| 03 『1年で億り人になる』 | 中央付近。白い「1年で」と黒い「億り人になる」の文字がある背表紙の本です。 | 書名と大まかな位置は一致。ただし、写真の「億り人になる」は白い文字です。この部分を黒い文字とする説明は、写真と一致しません。 |
| 04 『億万長者のすごい習慣』 | 中央より右。白い背表紙に、縦書きでタイトルがある本です。 | 書名は一致。中央より右にあり、白い背表紙・縦書きという説明も写真と整合します。 |
| 05 『お金の大学』 | 右側。水色と白を基調とした背表紙で、赤い文字のタイトルがある本です。 | 主な書名は一致。右側の位置と、背表紙・タイトルの色の説明も写真と整合します。 |
書名の一致は、回答に挙がった主な書名と、背表紙の表記との一致です。副題・著者名・版・ISBNまで照合した結果ではありません。左・中央・右は、境界を決めた測定ではなく大まかな位置として確認しました。
表の3冊目に注目してください。タイトルの読み取りと、文字の色の説明では結果が違いました。欲しい情報が一つ合っていた段階で、ほかの説明も正しいと扱わないことが、今回の実例から分かる確認のポイントです。
「確認できる事実」と「推測」を分けた回答
回答には、次の説明もありました。以下は提供された画面の書き起こしです。
写真から確認できる事実(実回答)上記の5冊については、背表紙に表示されている書名と、おおよその位置を目視で確認できます。
一方、ほかの本については、背表紙の一部が隠れているものや、文字が小さいもの、角度や光の影響で読み取りにくいものがあります。そうした部分の文字は、確認できないとします。
推測になること(実回答)本の内容、著者名、出版年、版の違いなどは、背表紙の文字だけではすべて確認できません。そのため、読み取れない情報を推測で補っていません。
また、上記の位置説明は写真内での相対的な位置を示したものであり、厳密な棚の区画を表すものではありません。
確認できない情報を分けて書いた点は、回答を読む手がかりになります。ただし、読めなかった本の名前や箇所を一冊ずつ示した回答ではありません。特定の本を確認したい場合は、「左から4冊目」などと対象を絞り、読めない箇所も具体的に答えてもらうと照合しやすくなります。
質問・補足の回答画面を見る(2枚)
画面は横に動かして読めます。書名・位置・説明の文章は、上の表と書き起こしでも確認できます。
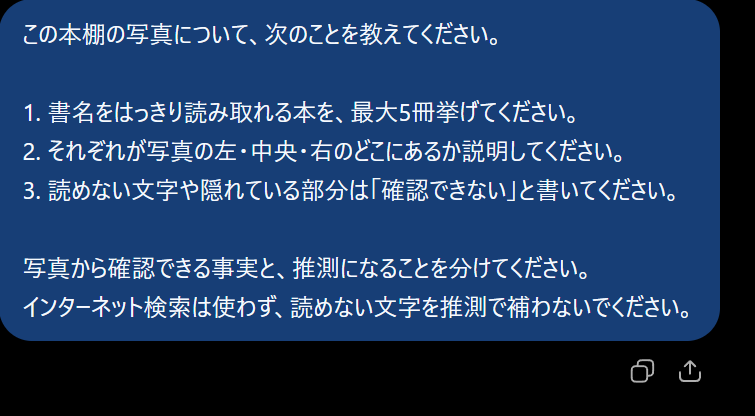
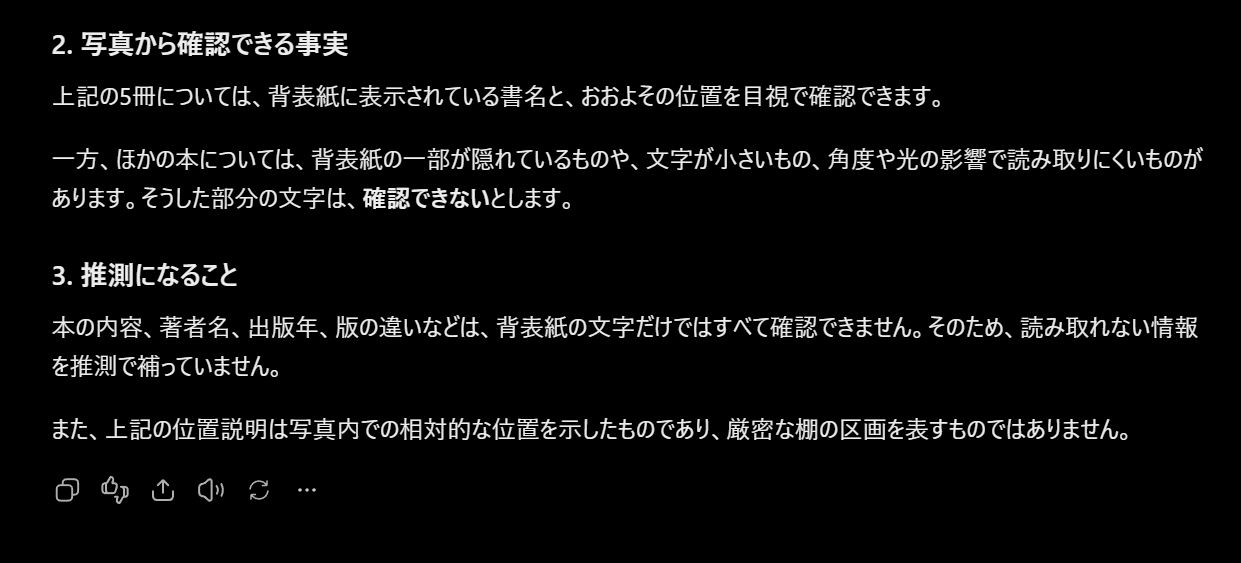
写真1枚への、掲載した1回分の回答を確認した記録です。最大5冊を挙げる質問なので、本棚の全冊を正しく読めた結果や、読み取り精度の一般的な数値には広げられません。今回の質問、写真の文字の大きさ、明るさ、利用環境に沿った一例として見てください。
画像・音声・動画が使えると、何が便利になる?
すべてを文章で説明しなくても、説明したい物や画面そのものを渡せることが利点です。ただし、受け取れる形式や処理できる内容は、サービスと機能によって変わります。
| 渡す情報 | 頼める作業の例 | 確認したいこと |
|---|---|---|
| 写真+文章 | 写っている物の説明、配置の比較、写った文字の読み取り。 | 小さい文字、隠れた部分、物の個数を読み違えていないか。 |
| 画面のスクリーンショット+文章 | エラー文の整理、画面に見える選択肢や操作の相談。 | 説明されたボタンや表示が、実際の画面にあるか。 |
| 音声 | 声での会話、録音の文字起こし、発言の要点の整理。 | 聞き取りにくい語、人名、数字、話者の取り違え。 |
| 動画 | 映像や音声の内容についての質問、出来事の整理。 | 該当する時刻の映像・音声と、回答が合うか。 |
| 資料ファイル | 文章の要約、表や図についての質問。 | 渡したファイルのどの情報まで読み取れる機能か。 |
たとえば操作の相談なら、画面を一から文章で再現する代わりに、スクリーンショットを見せて「右側のエラー文を読んで」と頼めます。説明する負担を減らし、同じ箇所について話しやすくなります。
PDFには文字、表、写真、図などが入っています。ファイルを渡せたことだけで、すべてのページや図が同じように読み取られたとは判断できません。ファイルを扱う機能の仕様と、実際の回答を確認しましょう。
表は利用場面の例です。本記事で実際に照合したのは、本棚写真1枚への掲載した1回分の回答です。音声・動画の精度比較は行っていません。
ChatGPTやGeminiにも、マルチモーダルの機能がある
画像を見せて、目的を伝える
公式の画像入力ガイドでは、スクリーンショットや図、参考画像を添付し、見てほしい箇所と求める結果を伝える使い方が案内されています。
音声でのやり取りも、使い方の一つです。OpenAIはデスクトップアプリでのChatGPT Voiceを案内しています。音声の利用条件はプランや提供状況により変わるため、使う画面で確認しましょう。
音声の案内:OpenAI|ChatGPT Voice。
同じサービスでも、モデル・プラン・端末・提供状況によって使える機能は異なります。また、開発者向けAPIの仕様と、一般向けアプリの仕様は分けて確認してください。
写真を渡すときは、「どこを・何のために・どう答えるか」を伝える
写真だけを送って「これどう?」と聞くと、物の説明が欲しいのか、配置の相談がしたいのか、AIが判断しにくくなります。画像の役割と質問の目的をはっきりさせると、回答を確認しやすくなります。
- 見てほしい対象を指定する「机の上」「画面右側のエラー文」など、対象を絞ります。
- してほしい作業を指定する物の一覧、文字の読み取り、2枚の違いなど、何が欲しいか伝えます。
- 不明な点の扱いを決める見えない部分は推測せず、確認できないことを分けて書いてもらいます。
この写真の机の上に見える物を、箇条書きで説明してください。
写真から確認できることと、推測になることを分けてください。
文字が読めない部分や、物の種類を判断できない部分は「確認できない」と書いてください。
画面右側にあるエラー文を、見えるとおりに書き出してください。
次に確認する場所を、画面に表示されている名称で教えてください。
この画像だけでは分からない原因は、確定した事実と分けてください。
この節の2つは、用途に合わせて使える質問例です。「不明」と書く指示をしても、読み違いを完全に防げるわけではありません。
画像に合わせた目的・対象・制約の指定:OpenAI|Image inputs。質問文は本記事の提案です。
あわせて読みたいAIへの質問を具体的にするコツ文章での質問でも使える、目的・条件・出力の指定を紹介しています。画像を渡しても、見間違いや推測は起こる
画像を受け取れることと、画像の内容を必ず正しく判断できることは同じではありません。読み取った情報から、もっともらしい説明を作ってしまう場合もあります。
| 回答を読むときの区分 | 机の写真での例 | 確認の方法 |
|---|---|---|
| 写真に見えること | 物の形、色、配置、読み取れる文字。 | 自分でも写真を見て、説明と照合する。 |
| 見た目から推測したこと | 材質、製品名、物の用途など。 | ラベル、型番、実物の情報が必要か確認する。 |
| 写真だけでは分からないこと | 撮影者の意図、隠れた部分、写っていない物。 | 別の写真や説明を追加する。回答の断定をそのまま採用しない。 |
OpenAIの画像理解の技術資料では、小さい文字、回転した画像、精密な位置関係、個数の数え方などに限界があると説明されています。Googleも、鮮明で正しい向きの画像を使うことを案内しています。
限界:OpenAI|Images and vision「Limitations」。画像の用意:Google|画像の理解。具体例の区分は本記事の整理です。
写真に合う説明ができても、その物の性質や、写真にない事情まで分かっているとは限りません。何を根拠に答えているかを確かめると、使える部分と確認が必要な部分を分けられます。
写真と回答を、3つの手順で見比べる
- 確認する画像を整える対象が分かるように撮り、必要な部分の文字を読める大きさにします。関係のない個人情報は写さないようにします。
- 物・文字・位置を照合するAIが説明した物は本当にあるか、文字を書き間違えていないか、左右や個数は合うかを確認します。
- 足りない情報だけを追加するラベルの拡大写真や別の角度など、確認に必要な情報を追加します。読めなかった部分を、AIの推測だけで埋めないようにします。
回答をそのまま使う前に、画像のどこに根拠があるかを一度確認してください。料金や営業時間など最新の情報が必要なら、写真の撮影時点と現在の公式情報も分けて考えます。
あわせて読みたいAIがもっともらしい間違いを答えるときの確認画像の説明でも、元の情報と出典を照合する姿勢が役立ちます。画像・資料についてのよくある疑問
Q. 画像を説明することと、画像を生成することは違う?
画像の説明は、渡した画像を手がかりに回答を作る作業です。画像生成は、指示や参考画像を使って画像を作る作業です。同じサービスに両方の機能があっても、目的を分けて頼みましょう。
Q. 写真の中の文字を読む機能はOCRと同じ?
文字を読み取るという目的は重なります。マルチモーダルAIでは、文字に加えて画像の配置なども質問に使えます。ただし、読み取れた文字の正確さは原画像と照合してください。
Q. ファイルを添付できれば、図や表も全部読める?
添付できたことだけでは判断できません。ファイルの形式、読み取る機能、資料の作り方によって扱える情報が変わります。該当するページや表を指定し、回答の根拠を確認しましょう。
Q. うまく読み取れないとき、何から直せばよい?
画像の向き、文字の大きさ、ぼけ、対象の隠れ方を確認します。次に、見てほしい場所と答えてほしいことを絞って伝えます。改善しても、必ず正しく読めるとは限りません。
Q. 5冊の書名が一致したら、いつも正しく読める?
今回の写真で回答に挙がった5冊が一致した結果です。写真の全冊を確認したものではなく、ほかの画像や条件での精度も測っていません。今回のように、書名と文字色の説明で結果が違う場合もあるので、必要な項目をそれぞれ照合してください。
画像と目的を一緒に渡し、根拠を確かめよう
- マルチモーダルは、複数の情報の種類を扱うこと。写真と文章などを組み合わせて使えます。
- 見る場所・作業・答え方を伝える。「これどう?」より目的が分かる質問にします。
- 書名が合っていても、見た目の説明まで照合する。本棚の実例では、5冊の主な書名は一致し、文字色の説明には相違がありました。
- 見えることと推測を分ける。元の画像や資料に根拠があるか確認します。
参考資料・確認した情報
- OpenAI|Image inputs
画像の添付、目的・対象・制約を伝える方法。 - OpenAI|ChatGPT Voice
デスクトップアプリでの音声機能と提供条件。 - OpenAI|Images and vision
開発者向けの画像理解と、読み取りの限界。 - Google|画像の理解
開発者向けの画像質問・画像の用意・マルチモーダル入力の説明。
公式資料は2026年10月12日に確認しました。APIの容量や回数の上限を、一般向けアプリの上限として掲載していません。本棚の写真と質問・回答画面は、筆者が提供した実記録です。AIの説明の書き起こしと、本記事による照合を分けて掲載しています。その他の質問例・確認表・説明図は、使い方の説明として作成しました。